沒有知識的智慧體,回起信來流暢而空泛。大多數令人失望的第一稿,不是壞掉的 智慧體寫的 —— 而是一個運作完全正常的智慧體,只是什麼都還沒被告訴。
知識掛在智慧體上,不在信箱上。把智慧體養好一次,它回信的每一個管道拿到 的都是同一份材料。
放在哪裡
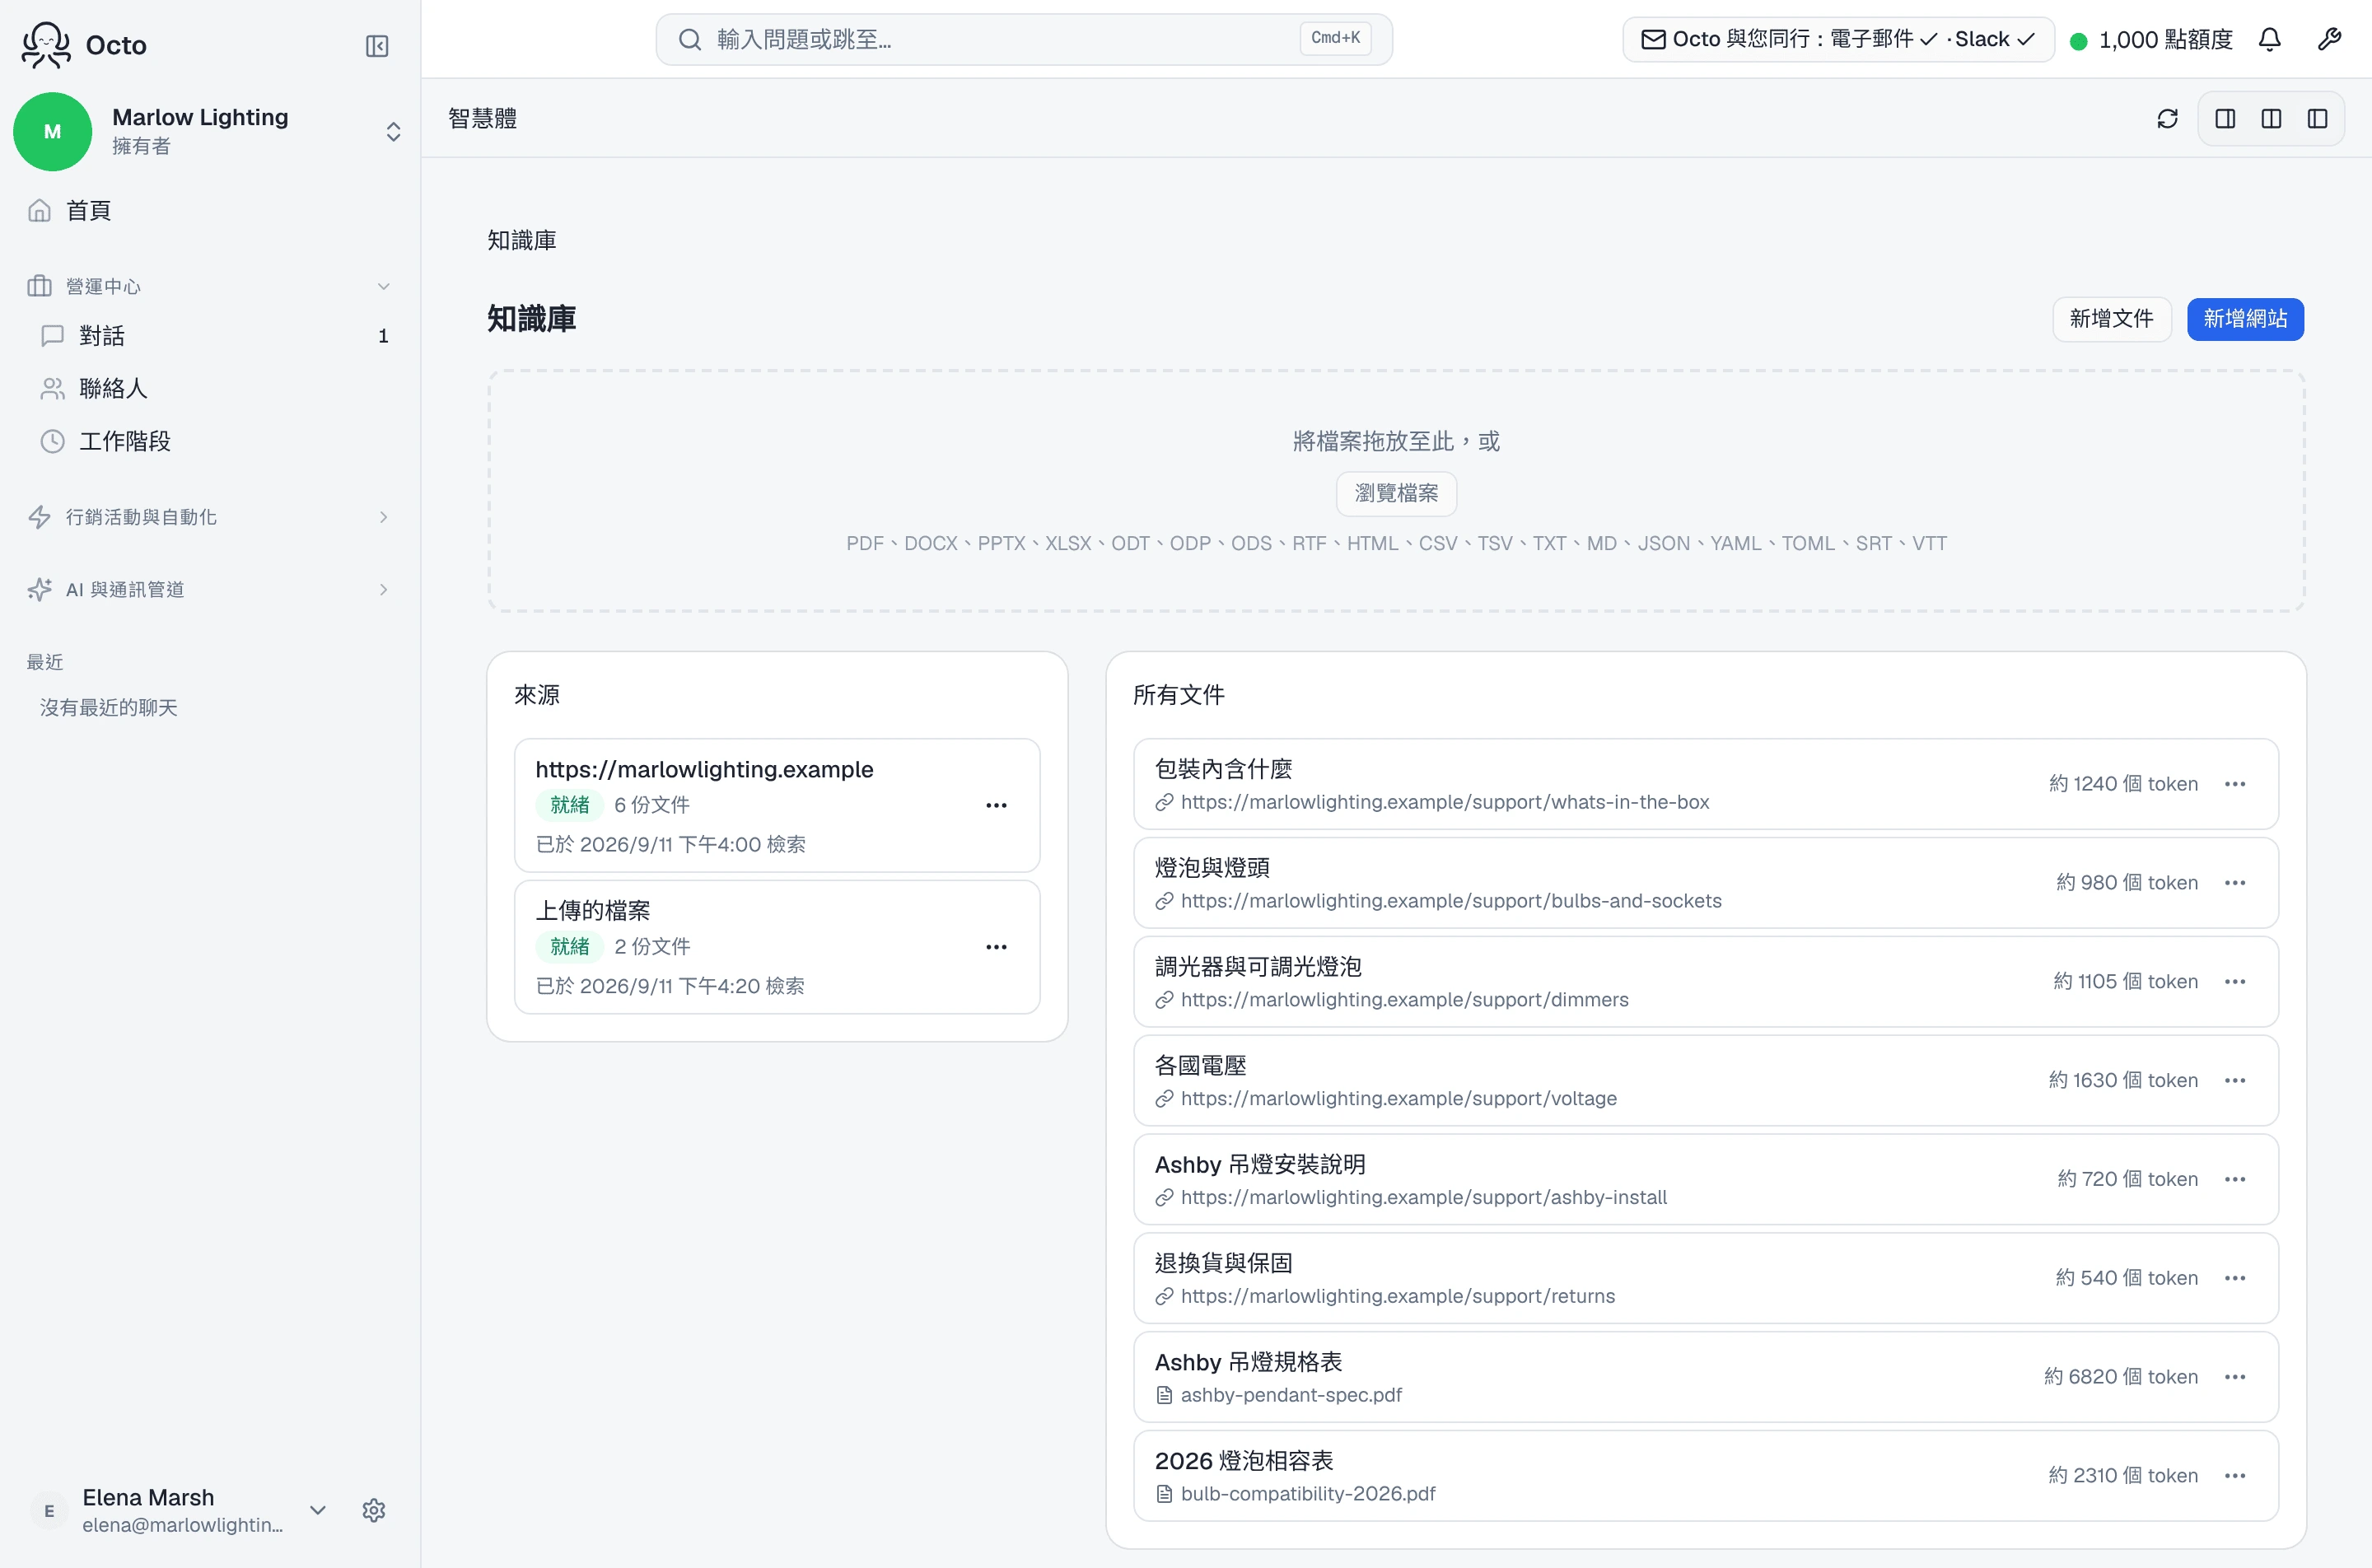
/agents/knowledge。如果你還沒建過智慧體,頁面會直說:「請先建立智慧體, 再新增知識作為其依據。」
空的知識庫會顯示 *「尚無來源。新增網站或上傳檔案即可開始。」*三個入口:
- 新增網站 —— 抓取你指向的頁面。每個來源保留自己的紀錄,顯示上次抓取 時間和頁數。
- 上傳檔案 —— 你手邊已有的文件。
- 貼上內容 —— 給那些存在某個人腦子裡、而不是存在檔案裡的東西。
寫成找得到的樣子
貼文字的方塊裡,帶著這一整頁最有用的一句建議:
撰寫或貼上 Markdown。使用 # 標題將文件切分成可搜尋的區段 — 每個標題都會 成為智慧體可引用的獨立區塊。
那不是排版偏好。檢索是以區塊為單位運作的,所以同一個標題底下一大面文字牆,
就是一個匹配得很差的大區塊;同樣的內容放在 # 退款、# 運送、# 營業時間
底下,就是三個精準的區塊。標題就是你控制什麼會被找到的方法。
有依據的回覆長什麼樣
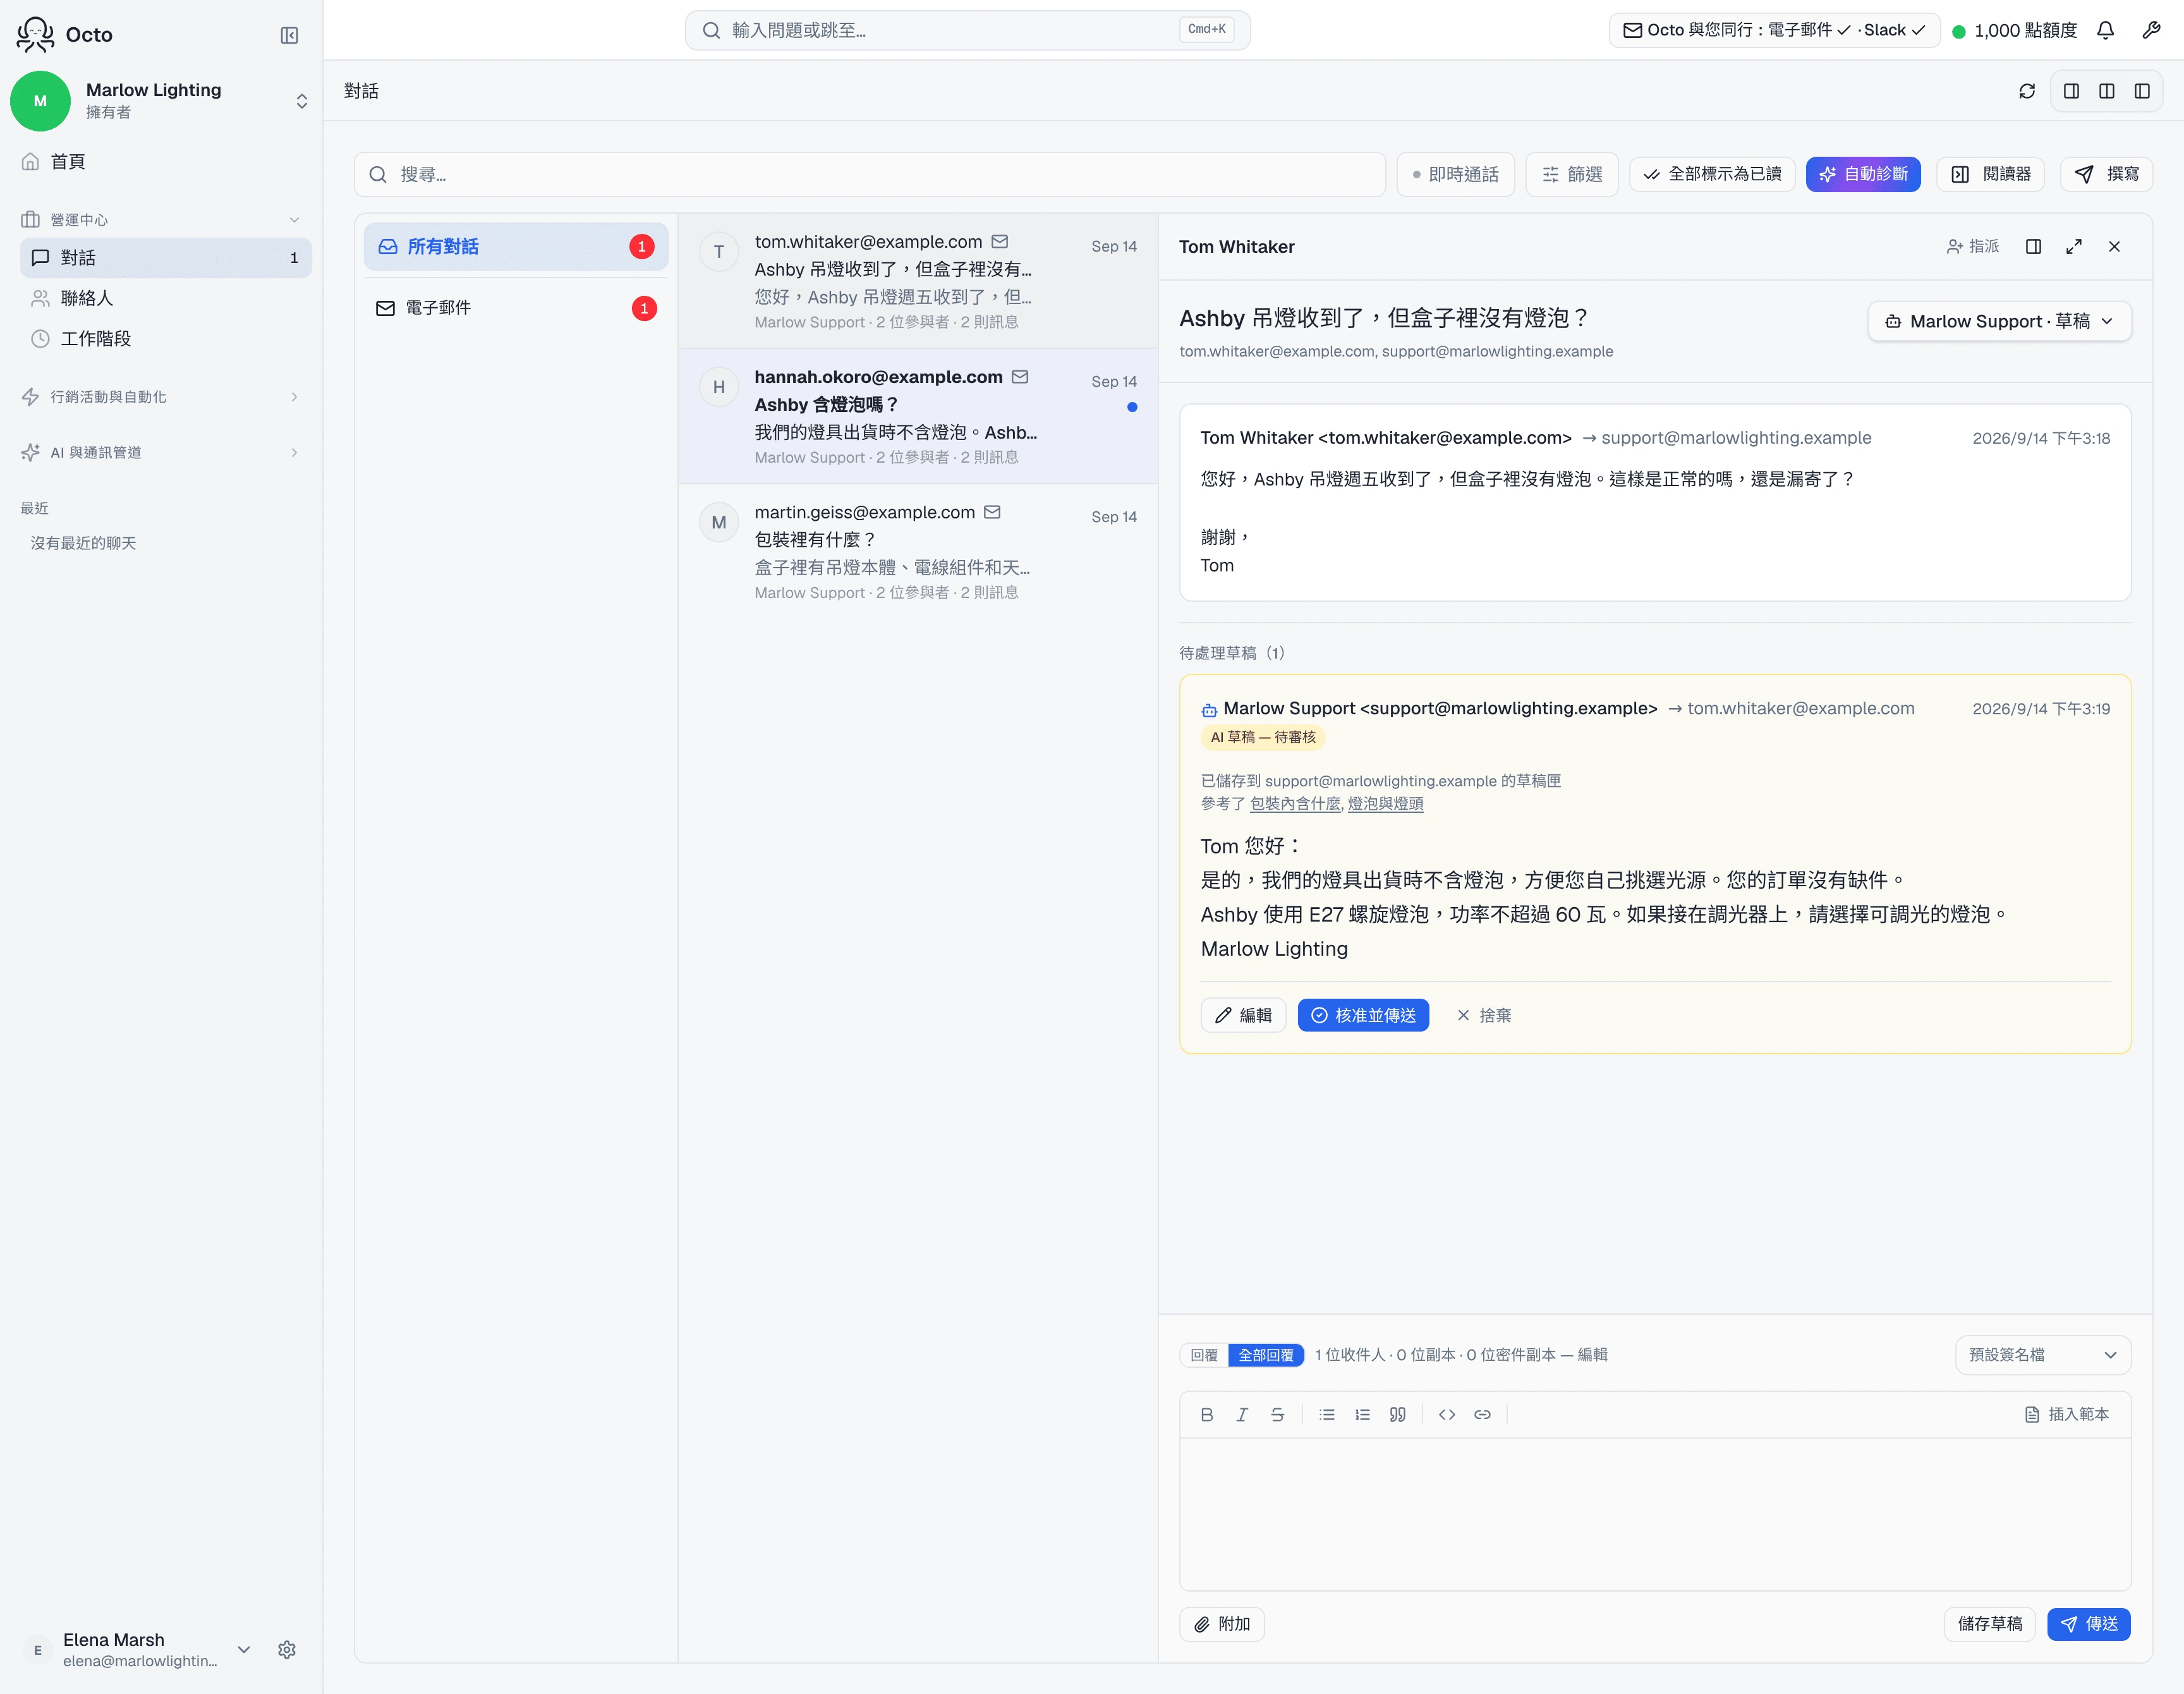
每一封草稿都會回報自己的依據來源,所以你永遠不用猜某個說法從哪裡來。有依據 的會標 參考了,並列出它讀了什麼。沒有依據的會說:
僅根據這串信件往來寫成——知識庫裡沒有相關內容
第二行是兩者裡更有用的那個。只根據討論串本身寫成的回覆,正是要最用力讀的 那一封,因為它裡面沒有任何東西對照過你寫的內容。同一個主題上常看到這一行, 就是在直接告訴你下一步該補什麼。
同一頁上的 知識缺口會替你收集這個訊號。
讓它保持是真的
被抓取的網站,從網站一改的那一刻起就過時了。重新檢索會重新整理一個來源 或單一頁面 —— *「正在重新檢索 — 頁面完成後會在此更新。」*價格、營業時間和 政策是過時了最傷的那幾種,因為一個對價格自信滿滿的錯誤回答,比沒有回答 更糟。
同樣的內容加兩次會被攔下來,而不是重複存放:『該內容已以「退款政策」存在 於您的知識庫中。未新增文件。』
它不會做的事
**它不會在每一封信上讀完你的整個知識庫。**超過一定大小之後,頁面會確切告訴 你變化是什麼:
大型知識庫(約 180,000 個 token)。 完整知識庫無法放入智慧體的上下文 中,因此它會針對每個問題搜尋相關段落來回答,而非一次看到全部內容。
這是任何真實知識庫的正常模式,也是標題的另一個理由 —— 搜尋找到的是區塊, 所以區塊必須是找得到的。
**它不是按信箱的。**知識屬於智慧體。同一個智慧體回的兩個信箱,不可能有不同的 知識;需要不同材料,就給它們不同的智慧體。
**它不會讓草稿自己寄出去。**依據改變的是回覆的內容,不是誰來核准 —— 那是 回覆模式的事。