没有知识的智能体回答邮件流畅而空泛。大多数让人失望的初稿不是智能体坏了 —— 而是一台 运转正常的智能体,什么都没被告诉过。
知识长在智能体上,不在邮箱上。给智能体喂一次料,它回答的每个渠道都吃到同样的东 西。
放在哪里
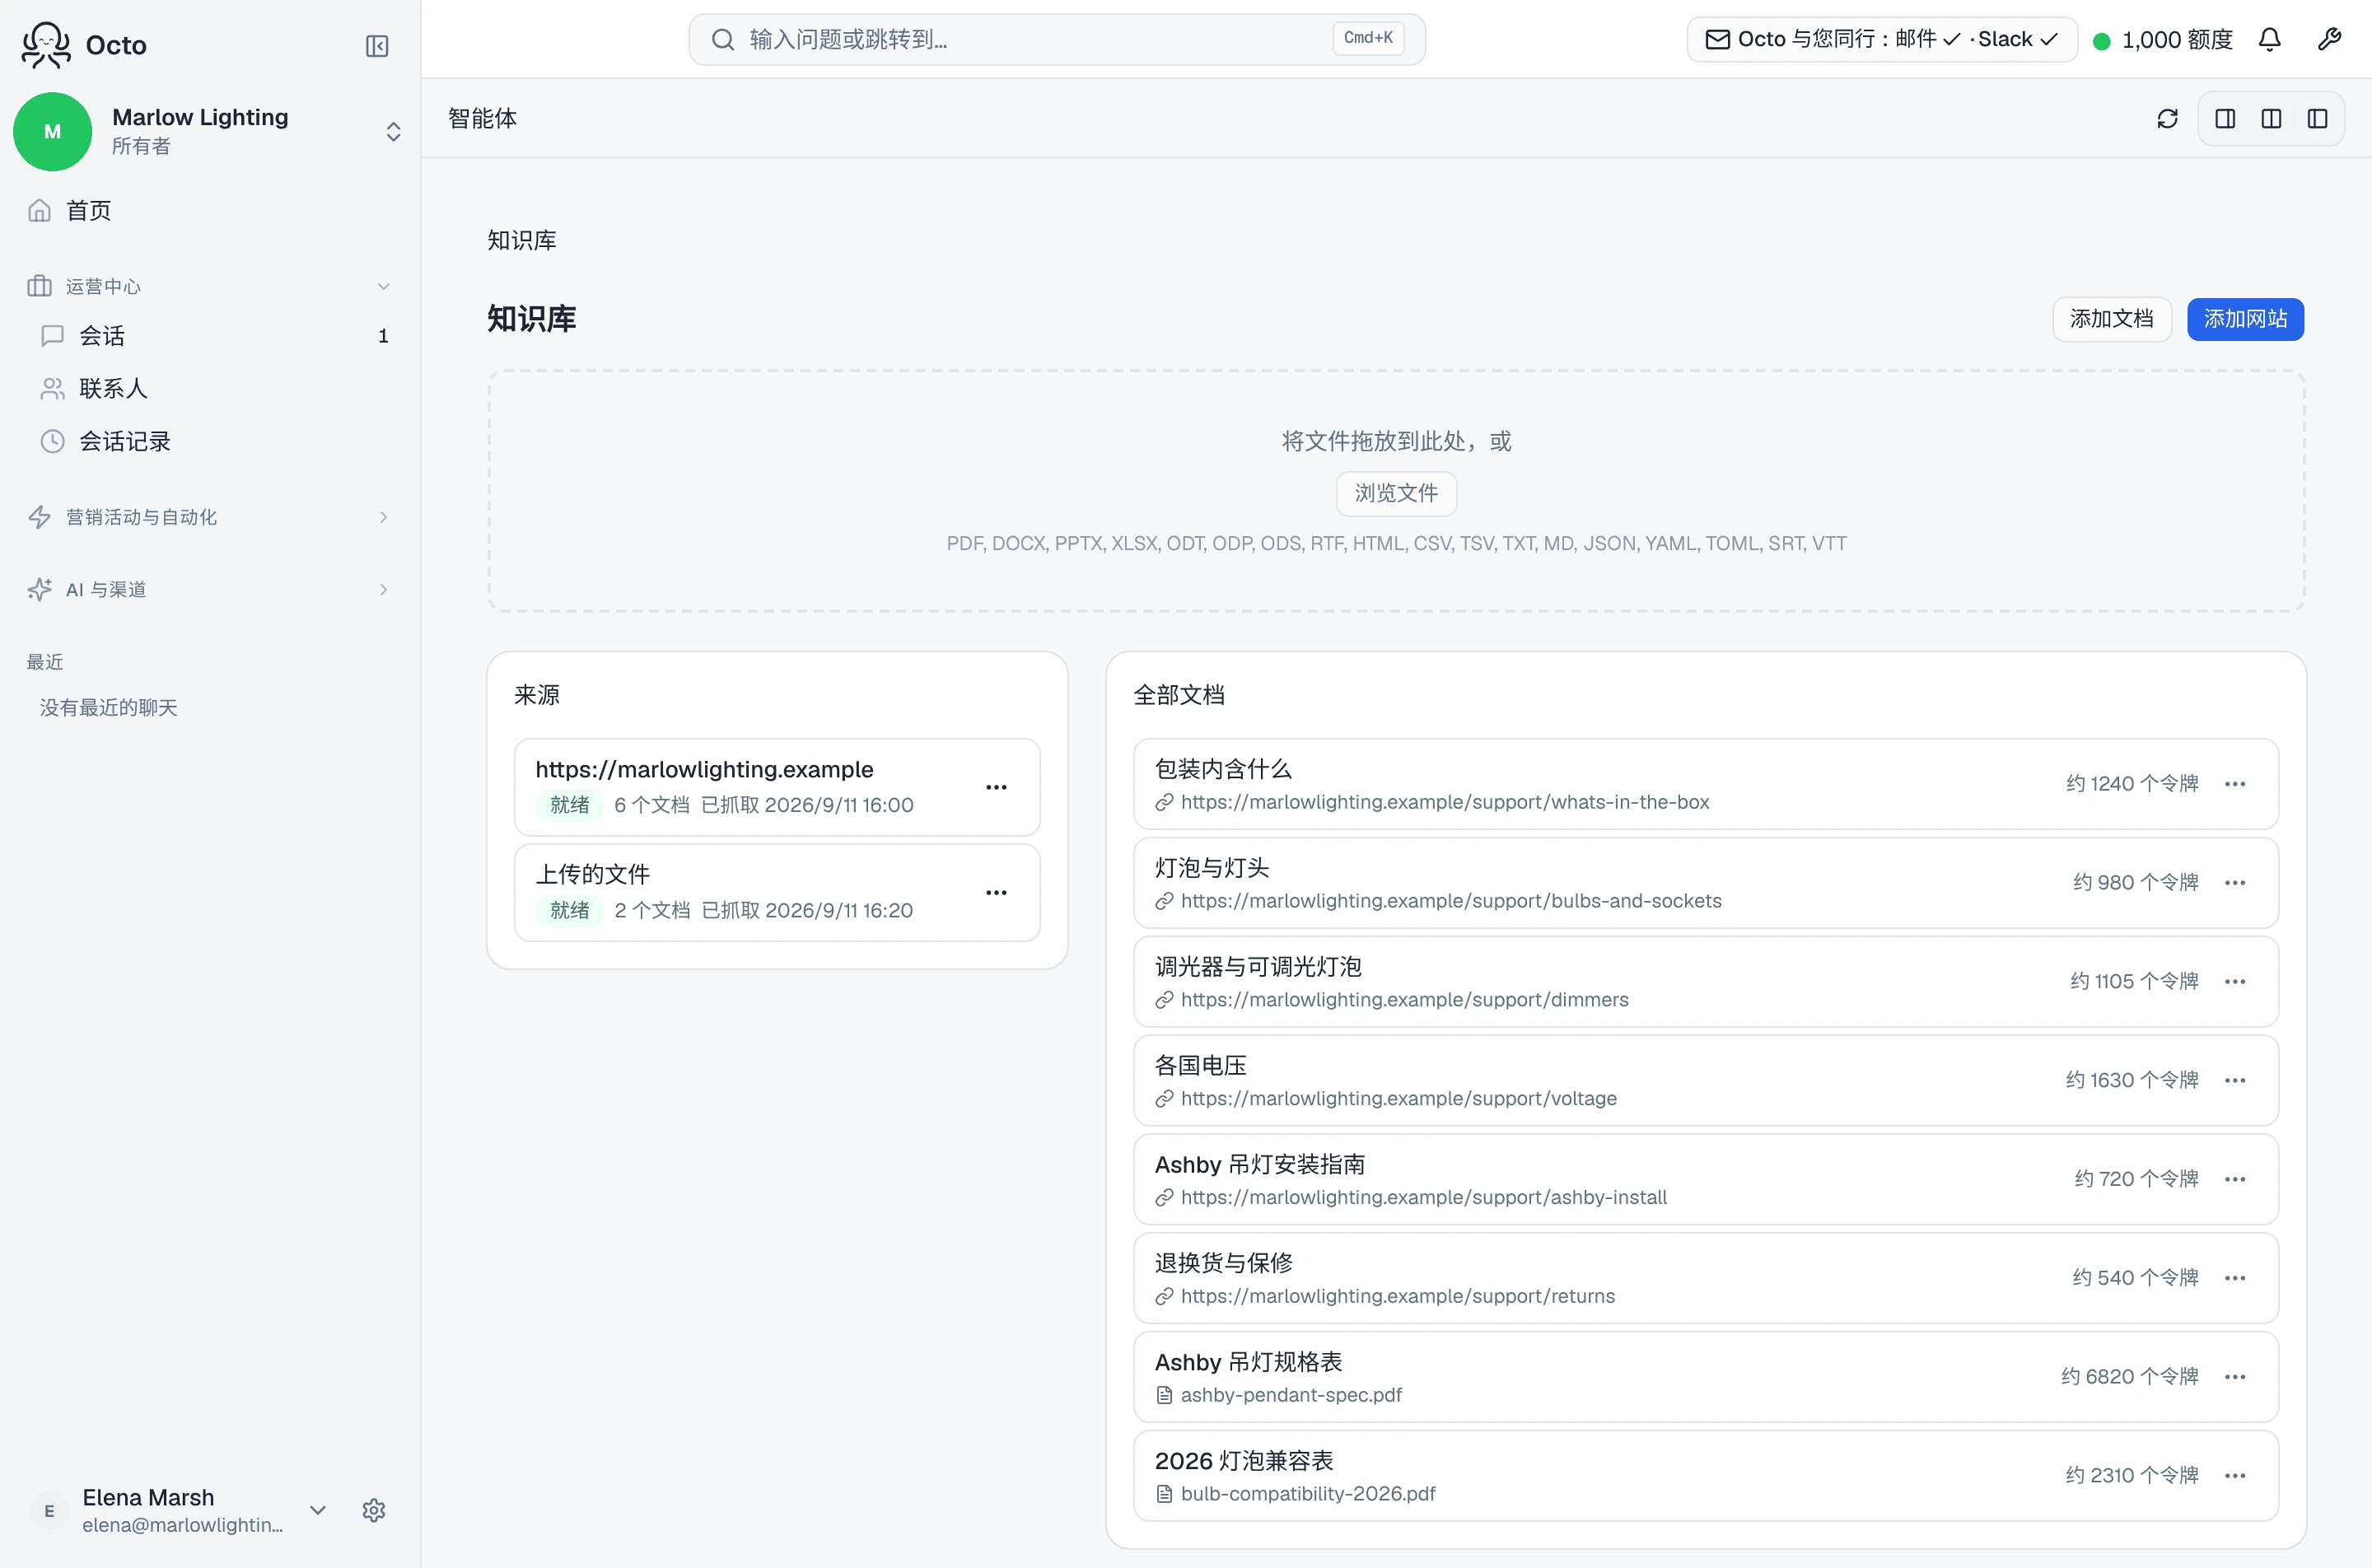
/agents/knowledge。如果你还没有建过智能体,页面会直说:“请先创建智能体,然后添 加知识作为其依据。”
空的知识库写着 *“还没有来源。添加网站或上传文件即可开始。”*三个入口:
- 添加网站 —— 抓取你指向的页面。每个来源有自己的记录,显示上次抓取时间和抓了多 少页。
- 上传文件 —— 你手上已有的文档。
- 粘贴内容 —— 给那些长在某人脑子里、不在任何文件里的东西。
写成能被找到的样子
粘贴框里放着这一页上最有用的一句建议:
撰写或粘贴 markdown。使用 # 标题将文档拆分为可检索的小节 — 每个标题都会成为智能体 可引用的独立片段。
那不是格式偏好。检索按片段工作,所以一个标题底下一整面墙的文字是一个匹配得很差的大
片段,而同样的内容放在 # Refunds、# Shipping、# Opening hours 下面就是三个精确
的片段。标题就是你控制什么会被找到的方式。
有依据的回复长什么样
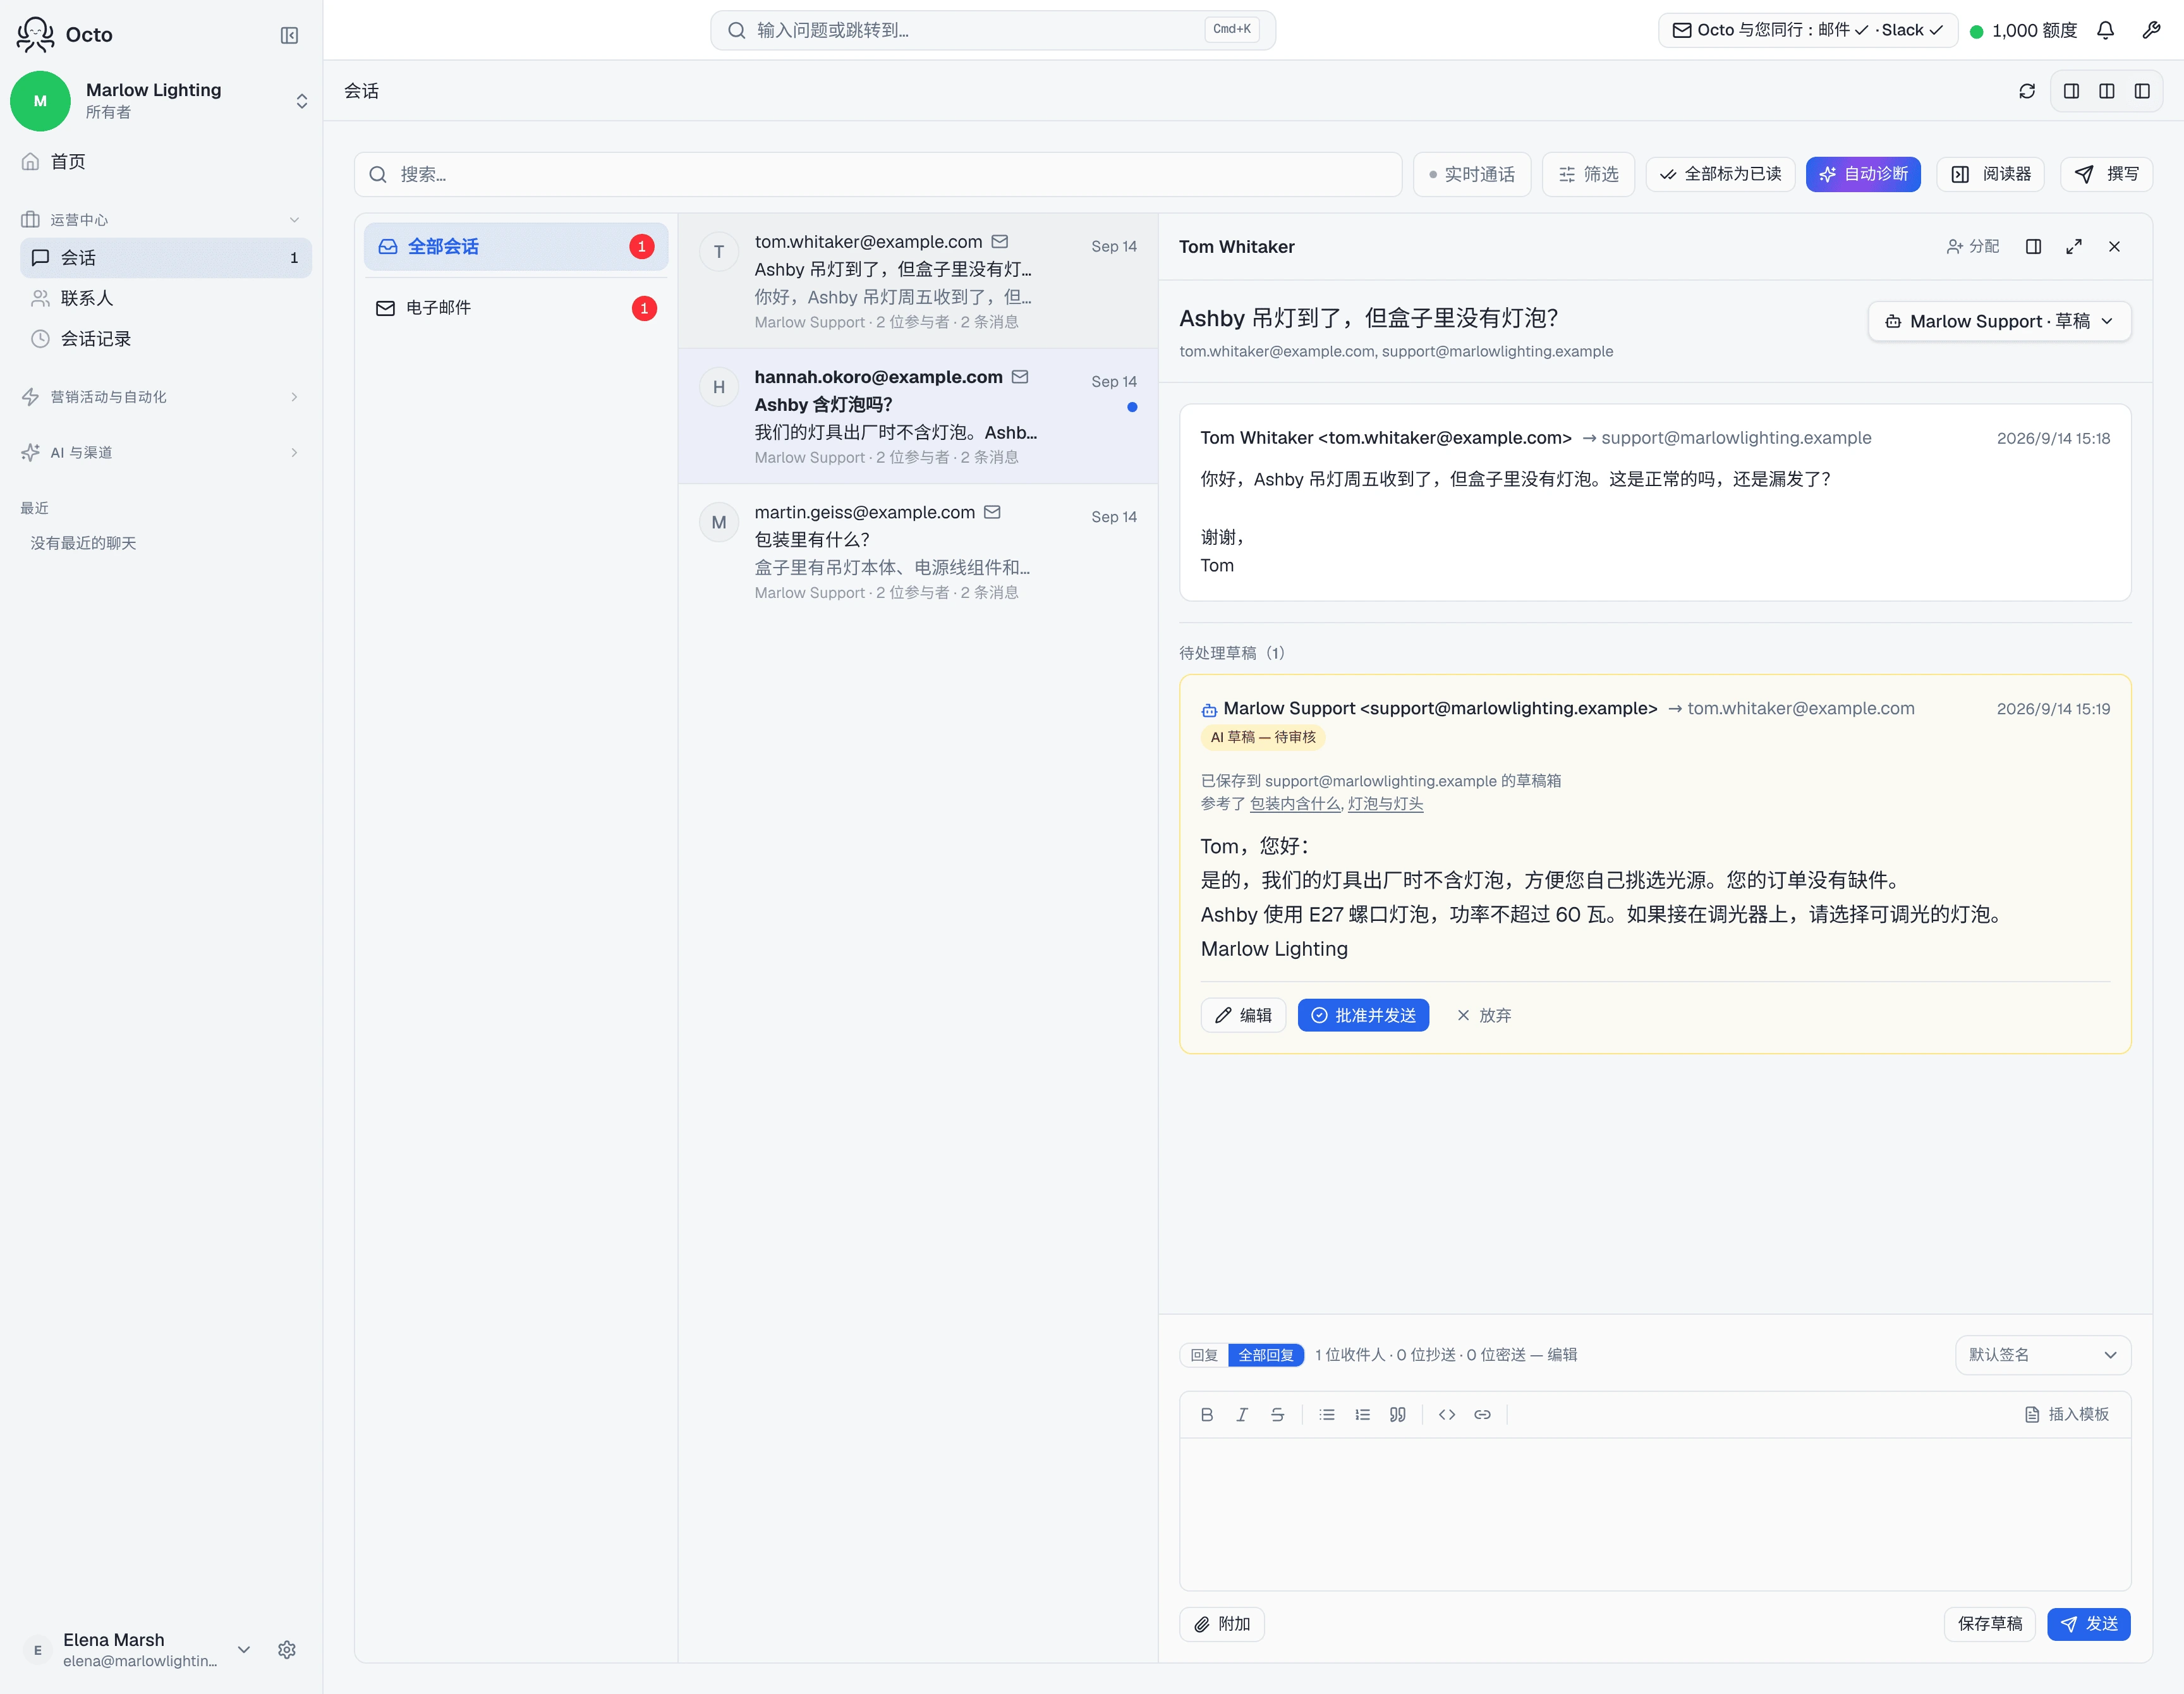
每封草稿都会交代出处,你永远不用猜一个说法从哪来。有依据的写着 参考了 并列出它 读了什么。没有依据的写着:
仅根据该邮件往来写成——知识库里没有相关内容
后一行是两条里更有用的那条。只根据会话写成的回复,正是要最用力去读的那种,因为里面 的任何东西都没有对照过你写下的内容。在某个特定话题上频繁见到它,就是在直接告诉你下 一步该补什么。
同一页面上的 知识空白 会替你收集这种信号。
让它保持为真
被抓取的网站,从网站变更的那一刻起就过期了。重新抓取刷新一个来源或单个页面 —— *“正在重新抓取 — 页面完成后将在此处刷新。”*价格、营业时间和政策是过期后最伤人的,因 为一个笃定错误的价格回答,比没有回答更糟。
同样的内容加两次会被拦下,而不是重复入库:“该内容已作为“Refund policy”存在于您的 知识库中。未添加新文档。”
它不会做的事
**它不会在每封邮件上读你的整个知识库。**过了某个规模,页面会精确告诉你变化是什么:
**知识库较大(约 180,000 个令牌)。**完整知识库无法放入智能体的上下文,因此它会针 对每个问题搜索相关段落来作答,而不是一次性查看全部内容。
对任何真实规模的知识库来说,这就是常态,这也是标题的又一个理由 —— 搜索找到的是片段 ,所以片段必须找得到。
**它不按邮箱区分。**知识是智能体的。同一个智能体回答的两个邮箱,不可能有不同的知识 ;需要不同素材,就给它们不同的智能体。
**它不会让草稿自己发出去。**喂料改变的是回复说什么,不是谁来批准 —— 那是 回复模式的事。