Tres formas de empezar
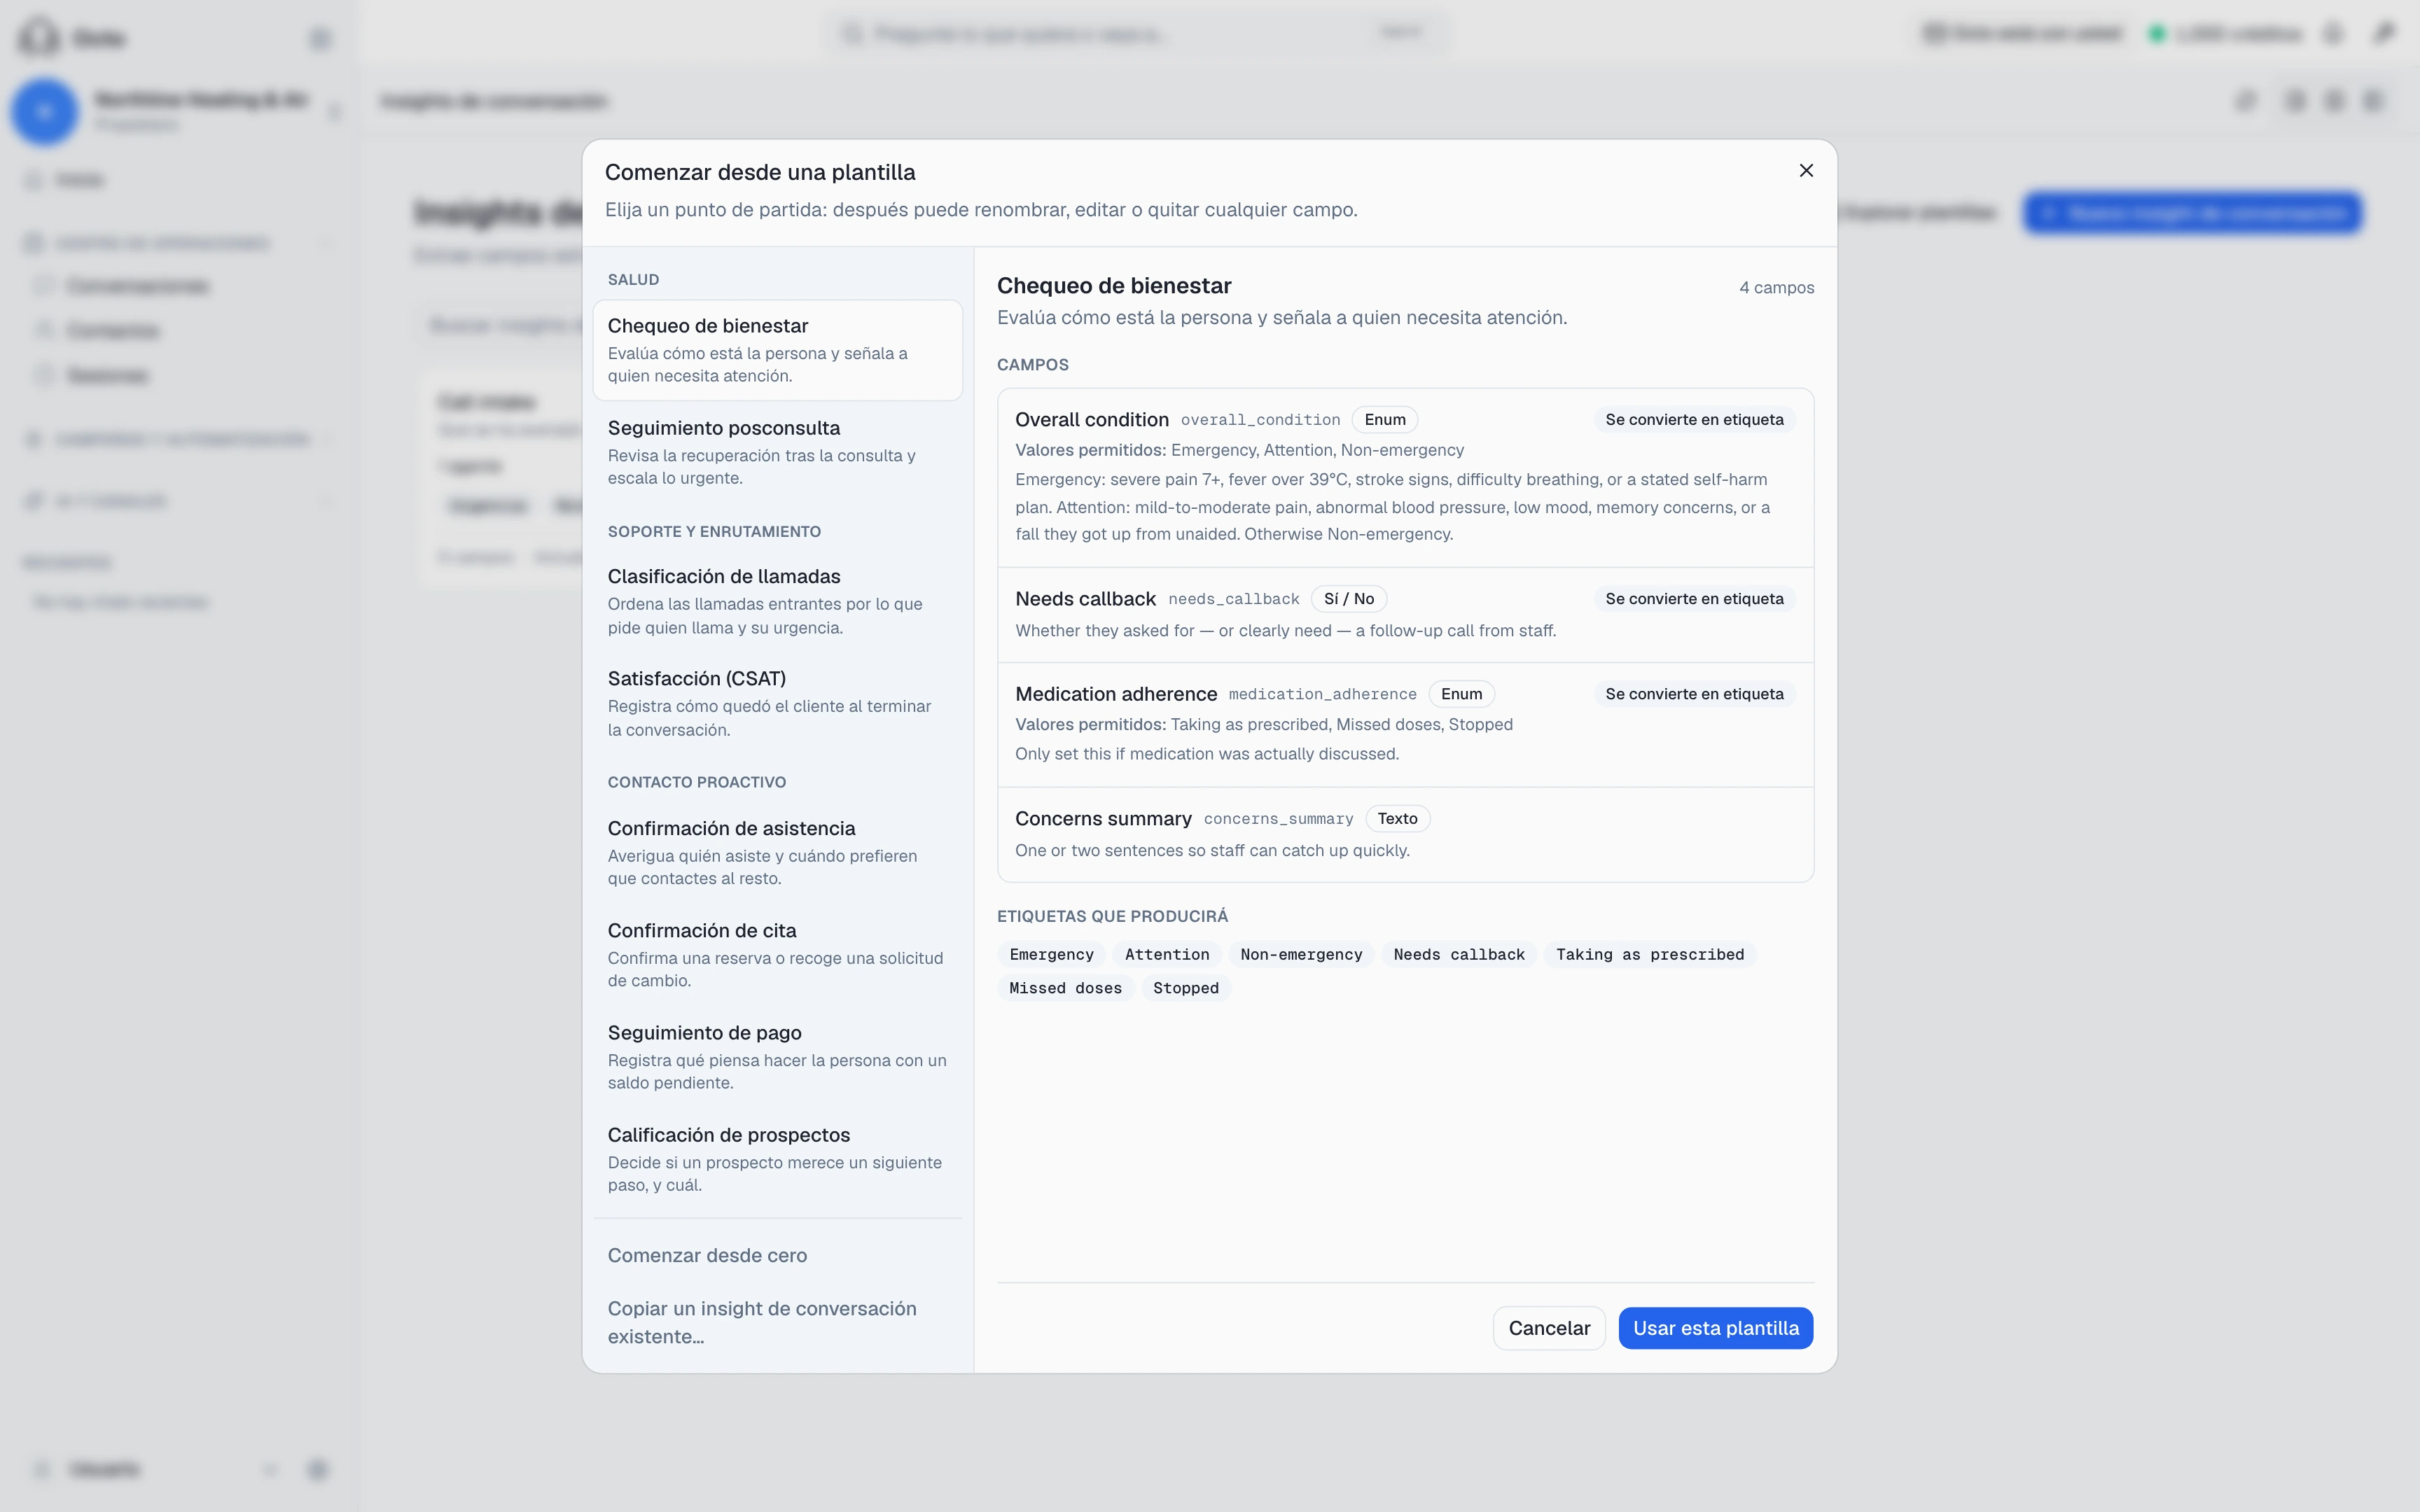
- La lista de Insights de conversación — Explorar plantillas abre “Comenzar desde una plantilla”, un selector con ocho plantillas integradas (Chequeo de bienestar, Clasificación de llamadas, Calificación de prospectos, Confirmación de cita, Confirmación de asistencia, Seguimiento posconsulta, Seguimiento de pago, Satisfacción). Cada una trae una descripción de una línea de para qué sirve, y al elegir una se muestra cada campo que trae antes de que te comprometas con ella. Nuevo insight de conversación, al lado, va directo a uno en blanco; Copiar un insight de conversación existente… parte de uno que ya construiste.
- La propia página de un agente — un botón Generar Dialog Insight que lee el system prompt de ese agente. Se explica más abajo.
- Octo, en el chat — las mismas operaciones de crear, editar y vincular son herramientas comunes que Octo puede invocar, así que “configúrame un Insight de conversación que pregunte X, Y y Z” es una frase, no un formulario.
Ninguna de estas formas produce un tipo distinto de Insight. Una plantilla solo llena un primer borrador — “después puede renombrar, editar o quitar cualquier campo”.
Los campos
Cada campo es un nombre, un tipo — Texto, Número, Enum, o Sí / No — y una Guía de extracción: “Indique a la IA exactamente cuándo establecer esto y cuándo omitirlo.” Esa frase es la instrucción real que sigue el modelo, no una nota para tu propia referencia, así que una guía vaga produce una extracción vaga. “Urgencia si alguien está en riesgo o algo dejó de funcionar por completo, Normal en cualquier otro caso” obtiene una respuesta consistente; “qué tan urgente suena” no. Hay lugar para el detalle real — hasta 8.000 caracteres — así que una regla de clasificación de varios niveles con su propia lista de síntomas y sus desempates no tiene que comprimirse en una sola frase.
Un campo Enum enumera sus valores permitidos, y cada uno tiene su propio nombre, su propio color y — aparte de la guía general del campo — su propia línea de criterios de extracción (para un valor llamado “Urgencia” eso es “¿Cuándo aplica Urgencia?”), hasta 2.000 caracteres por valor. Eso es a propósito una segunda caja, separada, en vez de un solo párrafo compartido: tres niveles de severidad compartiendo una única guía le dan al modelo unas pocas palabras de cada uno y empieza a adivinar entre ellos, que es justamente la falla que esto existe para evitar. Un color sin definir no queda neutro — se pinta ámbar, no gris, así que toda etiqueta de enum se ve elegida a menos que elijas otra cosa. Un enum sin valores “no restringe nada”, así que al menos uno es obligatorio, no un detalle opcional.
Emitir como etiqueta convierte la respuesta de un campo en una etiqueta sobre la conversación — “Solo una persona puede elegir un color, así que las etiquetas con color se muestran antes que las de la clasificación automática.” Si el valor que emitirías es uno que la clasificación automática ya aplica también, el editor te avisa antes de guardar: un flujo de trabajo activado por él “se activará desde dos orígenes”.
No partes de cero ni siquiera en un Insight en blanco. Toda extracción ya tiene, sin ninguna configuración: la transcripción completa, la duración de la llamada, el motivo de cierre, si se detectó buzón de voz, si se derivó a una persona, el canal y la dirección, y cualquier dato de contacto que ya esté en el registro. Los campos son para lo que eso todavía no responde.
Ejecutar una prueba — antes de que cueste algo de verdad
Ejecutar prueba corre la misma extracción sobre una conversación que elijas, para que veas qué produce hoy tu guía antes de que esté en vivo. Dos orígenes: Usar una conversación pasada o Pegar una transcripción. Una conversación guardada “usa el mismo modelo que el análisis normal de esa conversación”; una pegada usa el modelo predeterminado de la plataforma. De cualquier forma, “Las ejecuciones de prueba cuentan para el uso de LLM de su espacio de trabajo. Nunca escriben datos ni aplican etiquetas.” — cuesta dinero real y no cambia nada.
Guardar
Guarda, y un Insight que no está vinculado a nada lo dice sin rodeos: “Guardado. No se ejecutará hasta que lo vincule a un agente o campaña.” Un borrador guardado no es uno en ejecución.
Dónde vincularlo — un agente por defecto, o una campaña específica que anule ese valor por defecto — es su propia decisión, con dos formas de fallar que vale la pena conocer antes de elegir. Lee eso en “Qué pasa después de la llamada.”
Generar uno a partir de lo que el agente ya pregunta
La página de cada agente tiene un botón Generar Dialog Insight — no solo los agentes armados para encuestas. Lee el propio system prompt de ese agente y convierte lo que ya le está preguntando a quien llama en campos, así que no tienes que volver a escribir tus propias preguntas en un segundo formulario.
Son dos pasos separados, no un solo clic que cambia algo:
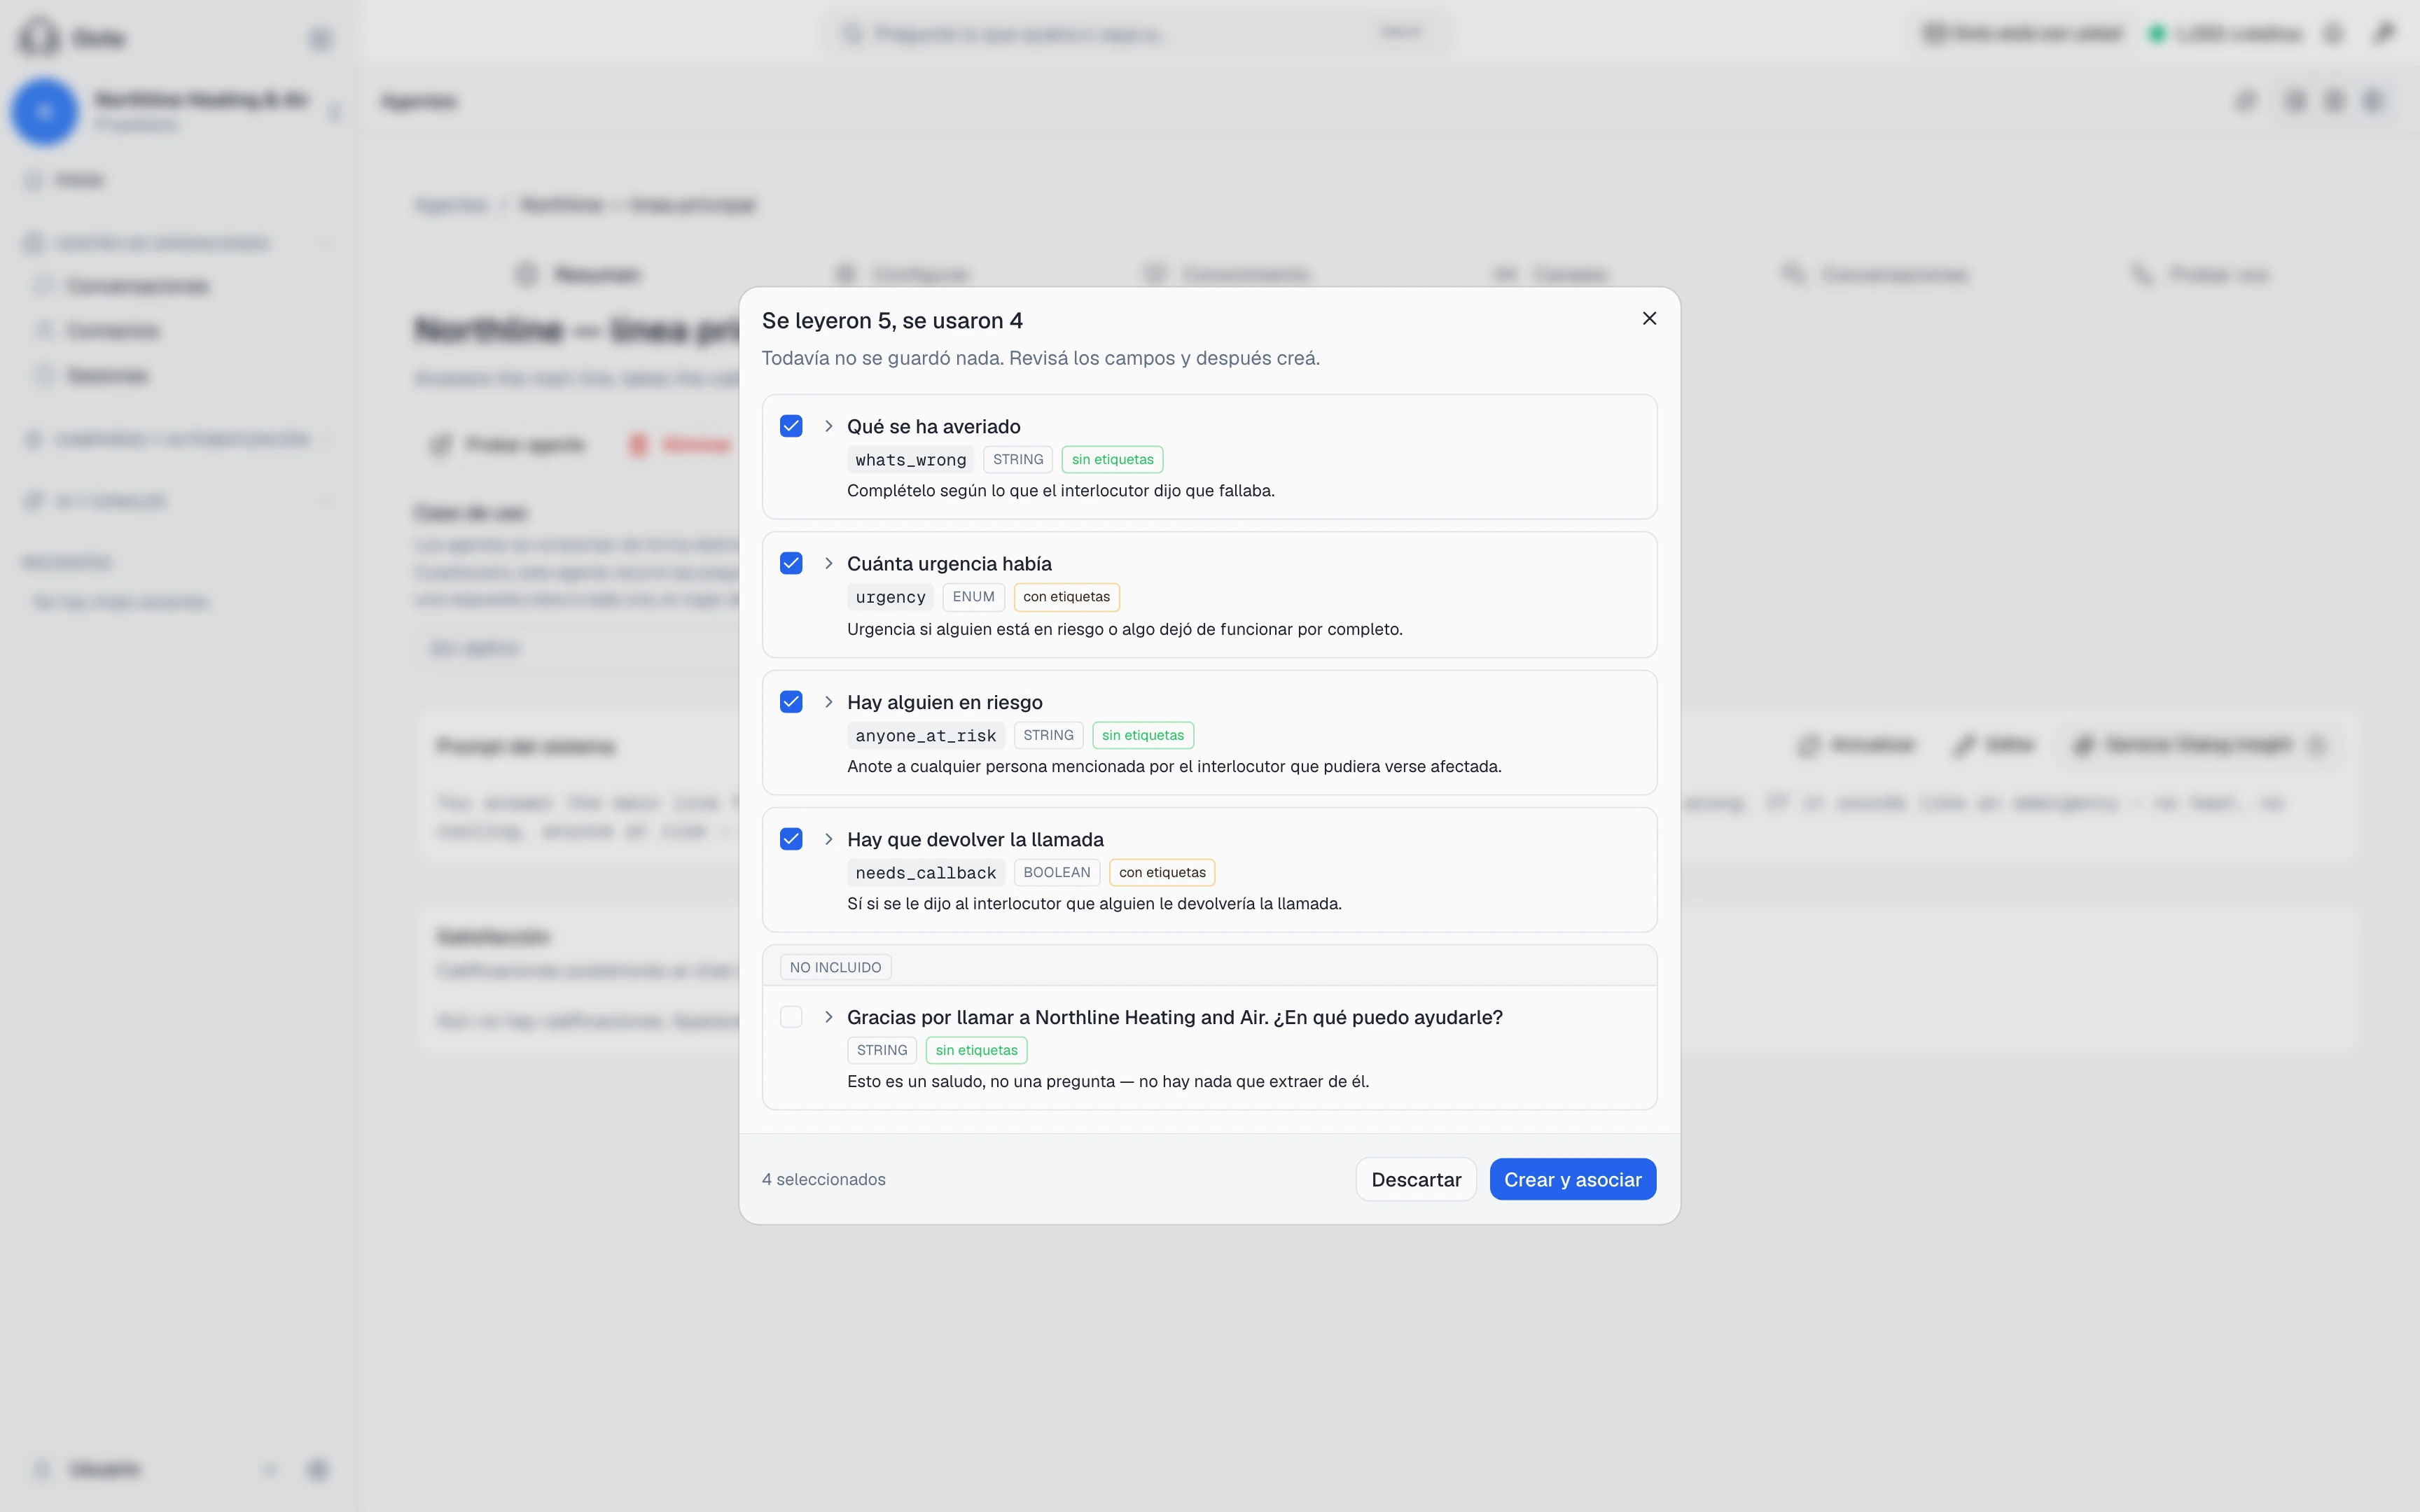
- Generar lee el prompt y propone campos. Todavía no se guardó nada — “Todavía no se guardó nada. Revisá los campos y después creá.” El propio título del diálogo dice exactamente qué encontró: “Se leyeron 5, se usaron 4” son 5 candidatos propuestos, 4 que sobrevivieron a lo que sea que el revisor haya descartado.
- Revisas la lista — cada campo propuesto se puede conservar o descartar — y solo entonces presionas Crear y asociar. Si estás regenerando sobre un Insight existente, el diálogo compara lo viejo contra lo nuevo, lado a lado, y te avisa con un número antes de confirmar si alguno de tus campos actuales quedaría afuera.
Nada corre sobre una conversación que ya terminó — “La extracción empieza en la próxima conversación. Las que ya terminaron no se procesan.” Y como el prompt puede cambiar después de generar a partir de él, el botón se acuerda: edita el system prompt más tarde y la página del Insight dice que los dos ya podrían no coincidir, con la opción de regenerar o editar los campos a mano en su lugar.